读论文:Attention Is All You Need
因为今天上午的面试需要从两篇论文中选择一篇(另一篇是 Discovering faster matrix multiplication algorithms with reinforcement learning)讨论,久仰大名故阅读之。
本文主要提出了完全依赖注意力机制,摒弃循环和卷积的模型,解决了之前长距离依赖路径长、训练无法并行与训练成本高的问题。
我们先来过一遍模型架构:
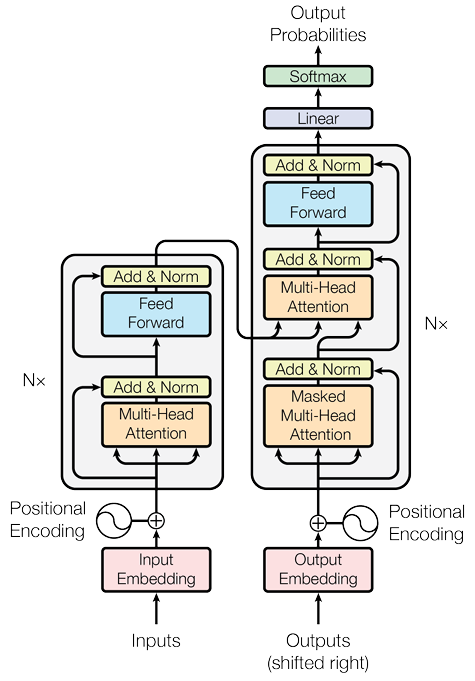
这篇论文在当时关心的是翻译问题,在大体上它是 encoder-decoder 架构1:前者将输入 $(x_1, \dots, x_n)$ 变成一组表示 $(z_1, \dots, z_n)$,后者将表示变成一组输出 $(y_1, \dots, y_m)$;这里,在训练时将翻译原句输入左边 inputs,将翻译结果右移一位(前面加上 <start> 标记 token,去掉末尾 token),做训练;使用时只将原句输入左边一次,然后右边从 <start> 开始,每过一遍生成一个词。
在左边的每一层中,先做 Multi-Head Attention,进行残差连接2与 Layer Normalization3,然后做 position-wise fully connected feed-foward network.
所谓 Attention 说的是,对于 $L \times d_{\text{model}}$ 的输入,我们用投影矩阵得到 $d_{\text{model}} \times d_k$ 维的 $Q, K$ 及 $d_{\text{model}} \times d_v$ 维的 $V$,分别代表查询条件、索引标签、数据内容。然后:
$$\text{Attention}(Q, K, V) = \mathrm{softmax}(\frac{QK^\top}{\sqrt{d_k}}) V$$
这里除以 $\sqrt{d_k}$,是因为:若假设 $Q, K$ 每一维上独立并且方差为 $1$,则积会有方差 $d_k$,需要降到 $1$ 才能正常4用 softmax.
然后一般来说 $d_{\text{model}} = hd_v$,Multi-Head Attention 是:
$$\text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \dots, \text{head}_h)W^O$$
每个 head 学习不同特征,然后融合起来。
这里 Multi-Head Attention 共有三种用法:在交叉注意力(左边到右边的箭头),左边给出 Key 与 Value,右边给出 Query;在 encoder 的 self-attention 层,所有的 Query、Key、Value 均来自上一层;在 decoder 的 self-attention 层,为了保证自回归性质(只知道过去不知道未来),将 $j > i$ 部分给“mask out”。
自注意力成功地使得,不同位置间的连接是 $O(1)$ 的(但计算、存储复杂度变为 $O(n^2)$),而传统方法则有长距离梯度消失/爆炸的问题。
这里的 Position-wise Feed-Foward Network 在两个线性变换中有一个 ReLU,即:
$$\text{FFN}(x) = \max(0, xW_1 + b_1) W_2 + b_2$$
这里 $d_{\text{model}} = 512$,中间维数 $2048$,中间维数高是为提高表达能力。
Postional Encoding 是为将位置信息编码进去。论文用的是分配不同的频率:5
$$ \text{PE} _{\text{pos}, 2i} = \sin (\text{pos} / 10000^{2i / d _{\text{model}}}) \\ \text{PE} _{\text{pos}, 2i + 1} = \cos (\text{pos} / 10000^{2i / d _{\text{model}}}) $$
关于 Embedding、优化器、正则化等参考原论文即可。
现代 LLM 是 decoder-only 的。
即 $F(x) + x$,这在深层神经网络可以防止梯度消失。
与 Batch Normalization 相反,分别对每个样本的所有特征做归一化。这里是 $\text{LayerNorm}(x + \text{Sublayer}(x))$,现代则大多用 $x + \text{Sublayer}(\text{LayerNorm}(x))$.
面试时被问不正常会怎样发现不会。实际上一般控制方差在 $0.5 \sim 1$,太大会容易饱和梯度变小,太小会让输出信号接近均匀。
现代会用 RoPE,每个词有一对分量,随位置施加旋转,这样旋转差只和位置差有关。