从反向传播到多层感知机
参考的是 Andrej Karpathy 的经典课程 Neural Networks: Zero to Hero 视频。
反向传播
反向传播是经典的底层机制,作者提供的仓库在 Micrograd.
我们考虑可以良好分层的树。先从源节点到汇节点(记作 $L$)将数据值正向传播(就是计算);然后考虑反向传播,在每个叶节点加一个字段 .grad 表示 $L$ 关于它的偏导,对 $e = \mathrm{op}(b_1, \dots, b_n)$ 只需:
$$\frac{\partial L}{\partial b_i} = \frac{\partial L}{\partial e} \cdot \frac{\partial e}{\partial b_i}$$
如果变量被重复使用,则梯度叠加即可。
def __add__(self, other):
    out = Value(self.data + other.data, (self, other), '+')
    def _backward():
        self.grad += out.grad
        other.grad += out.grad
    out._backward = _backward
    return out

def __mul__(self, other):
    out = Value(self.data + other.data, (self, other), '*')
    def _backward():
        self.grad += other.data * out.grad
        other.grad += self.data * out.grad
    out._backward = _backward
    return out
在反向传播时需要进行拓扑排序:
def backward(self):
    topo = []
    visited = set()
    def build_topo(v):
        if v not in visited:
            visited.add(v)
            for child in v._prev
                build_topo(child)
            topo.append(v)
    build_topo(self)

    self.grad = 1.0
    for node in reversed(topo):
        node._backward()
在 PyTorch 中,也存在对应的功能:
x1 = torch.Tensor([2, 0]).double()
...
o = torch.tanh(x1*w1 + x2*w2 + b)
o.backward()
假若我们希望让 $L$ 尽量大,则应该让源节点沿着梯度走某个微小的步长(a.data += a.grad * step),调整完所有源节点后,再做一次正向传播,如此循环。
现在考虑更现实的模型。考虑神经元,一个神经元接受 $x_1, \dots, x_n$,通过权重和偏置项(bias)计算 $\sum w_i x_i + b$,再将此值喂给一个激活函数,使之非线性。激活函数通常是压缩函数,如:
| 名称 | 效果 |
|---|---|
| Sigmoid | $1 / (1 + e^{-x})$ |
| Leaky ReLU | $\max(0.1x, x)$ |
| tanh | $\tanh(x)$ |
| Maxout | $\max(w_1^\top x + b_1, w_2^\top x + b_2)$ |
| ReLU | $\max(0, x)$ |
| ELU | $\begin{cases} x & x \geq 0 \cr \alpha (e^x-1) & x < 0 \end{cases}$ |
class Neuron:
    def __init__(self, nin):
        self.w = [Value(random.uniform(-1,1)) for _ in range(nin)]
        self.b = Value(random.uniform(-1,1))

    def __call__(self, x):
        act = sum(wi*xi for wi, xi in zip(self.w, x), self.b)
        return act.tanh()

    def parameters(self):
        return self.w + [self.b]

class Layer:
    def __init__(self, nin, nout):
        self.neurons = [Neuron(nin) for _ in range(nout)]

    def __call__(self, x):
        outs = [n(x) for n in self.neurons]
        return outs[0] if len(outs) == 1 else outs

    def parameters(self):
        return [p for n in self.neurons for p in n.parameters()]


class MLP: # 多层感知机
    def __init__(self, nin, nouts):
        sz = [nin] + nouts
        self.layers = [Layer(sz[i], sz[i+1]) for i in range(len(nouts))]

    def __call__(self, x):
        for layer in self.layers:
            x = layer(x)
        return x

    def parameters(self):
        return [p for layer in self.layers for p in layer.parameters()]
一个回归分析的例子,使用最小二乘法给出损失函数:
for k in range(20):
    # forward pass
    ypred = [n(x) for x in xs]
    loss = sum((yout - ygt)**2 for ygt, yout in zip(ys, ypred))

    # backward pass
    for p in n.parameters():
        p.grad = 0.0
    loss.backward()

    # update
    for p in n.parameters():
        p.data += -0.05 * p.grad
在实际应用中,数据集规模达到百万级别时,通常随机选取一个子集,称为批次(batch),只对它作计算。
有时使用 L2 正则化技术去增强泛化能力。
- 使用 Residual Connection,使得更深的层数不会变劣
- 选择 ReLU
- 进行好的初始化
- 使用 dropout,即每一层大量神经元时每次临时隐藏一半神经元
- 使用 weight decay,如加入 L2 正则
- 依据 batch size 调整 learning rate
- 使用 warm up 及 learning rate decay
Bigram
作者提供的仓库在 Makemore,是一个把字符视作基本元素,生成人名的模型。
最简单的方法是 bigram 模型。用 <S> 标记开头,用 <E> 标记结尾,统计所有的二元组在所有的词中的出现次数;在生成时,从 <S> 开始,每次按概率生成下一个字符,直到 <E>. 不过这样的效果很差。
为了衡量模型的优质程度,我们使用似然(likelihood),定义为整个概率表格中所有概率的乘积。为了方便计算我们使用其对数的负,再除以 $n$,这个值越高模型表现越差。我们也可以对一个指定的词计算这个值。
有时一个二元组从未出现过,计算时对数会变为负无穷。为了让模型平滑一些,我们将所有的计数增加 $1$.
现在用基于梯度的学习方法实现 bigram 的效果。我们准备 27 个接受 27 个输入的神经元,对一个单词的 $m$ 个二元组,将它们 one-hot 编码(编码为长 27 的数组,除一处是 1 外均为 0),然后前向传播得到概率:
# "Emma"
# xs = tensor([0, 5, 13, 13, 1])
# ys = tensor([5, 13, 13, 1, 0])

# 初始化神经元的权重
g = torch.Generator().manual_seed(2147483647)
W = torch.randn((27, 27), generator=g, requires_grad=True) # 正态分布 N(0, 1)

# one-hot 编码
import torch.nn.functional as F
xenc = F.one_hot(xs, num_classes=27).float()

logits = xenc @ W # 矩阵乘法 (m, 27) @ (27, 27) => (m, 27) 此结果表示对数计数值
counts = logits.exp()
prob = counts / counts.sum(1, keepdims=True)
# 最后两行合称 `softmax`
计算损失函数:
nlls = torch.zeros(5)
for i in range(5):
    p = probs[i, ys[i].item()]
    nll = -torch.log(p) # negative log likelihood
    nlls[i] = nll
loss = nlls.mean()

# 向量化地写为
# loss = -probs[torch.argane(5), ys].log().mean()
现在就可以仿照上一节做反向传播。
W.grad = None
loss.backward()
W.data += -0.1 * W.grad
改为考虑所有单词的所有二元组,然后增大 learning rate. 最终的效果不会好于 bigram,因为没有引入额外的信息;但这种方法更灵活,可以将它扩展到利用 $n$-元组的结果。
在这种方法中,等效于之前方法中平滑处理的是:尽量让权重 W 趋于零,进行这种引导的就是正则化方法。
loss = ... + 0.01 * (W**2).mean()多层感知机
如果用朴素的方法扩展到 $n$-元组,则需要的存储空间会相当巨大。
作者参考的论文是 Bengio et al. 2003,该论文中关注的是词(我们继续考虑字符),为 17000 个词中的每一个分配到一个 30 维的向量。建模方法则和之前是类似的:
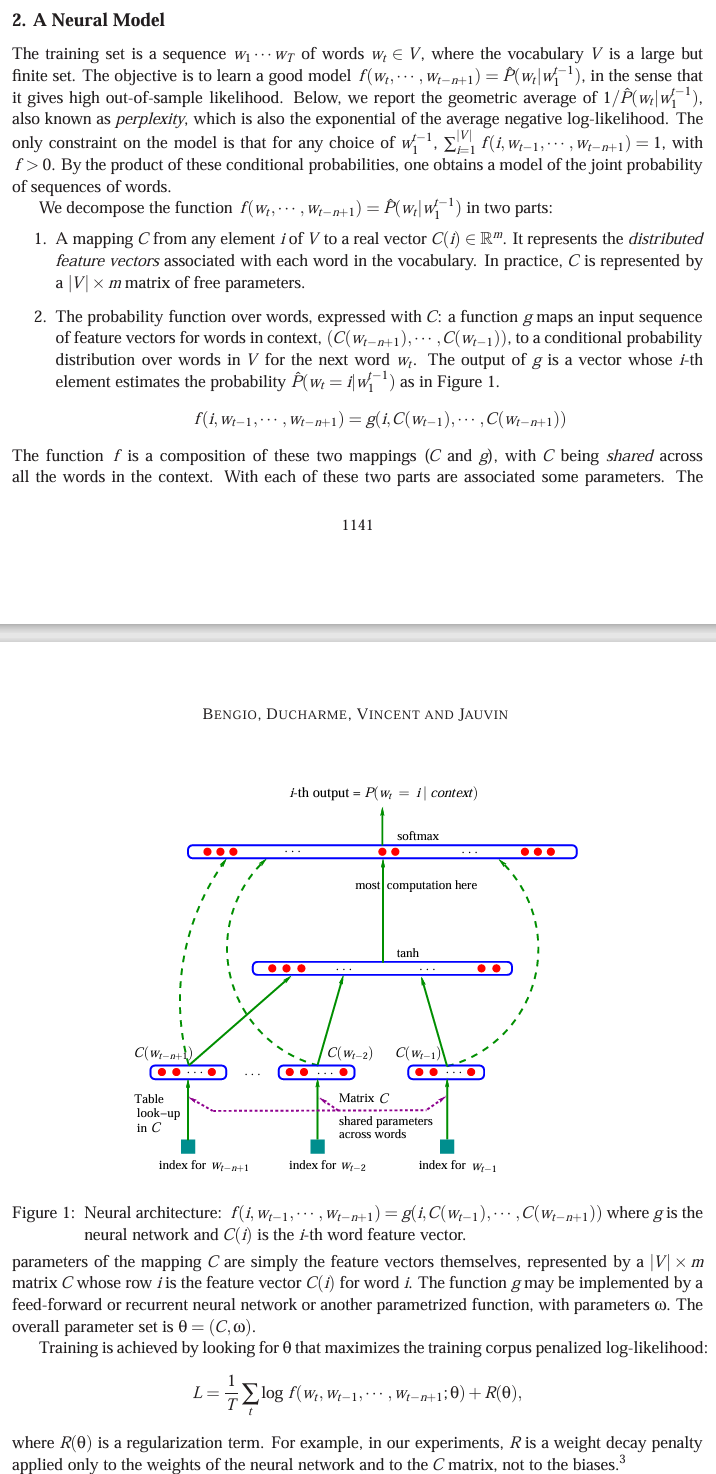
这里中间的那层称为隐藏层,其大小称为超参数,可任意设定。
vocab_size = 27
block_size = 3 # 用于预测下一字符的字符数
n_embd = 10 # 嵌入的维数
n_hidden = 200 # 隐藏层的神经元个数
max_steps = 200000
batch_size = 32 # 批次大小
g = torch.Generator().manual_seed(2147483647)

C = torch.randn((vocab_size, n_embd), generator=g)
W1 = torch.randn((n_embd * block_size, n_hidden), generator=g)
b1 = torch.randn(n_hidden, generator=g)
W2 = torch.randn((n_hidden, vocab_size), generator=g)
b2 = torch.randn(vocab_size, generator=g)
parameters = [C, W1, b1, W2, b2]

# minibatch construct
ix = torch.randint(0, X.shape[0], (batch_size,))

# forward pass
emb = C[X[ix]] # (batch_size, block_size, n_embd)
embcat = emb.view(emb.shape[0], block_size * n_embd) # (batch_size, n_hidden)
# tensor 实际上是用一维数组存储的,所以直接 `view` 即可
# 参数也可改为 `-1` 表示自动推断

hpreact = embcat @ W1 + b1
h = torch.tanh(hpreact)

logits = h @ W2 + b2 # (batch_size, vocab_size)
# counts = logits.exp()
# prob = counts / counts.sum(1, keepdims=True)
# loss = -prob[torch.arange(batch_size), Y].log().mean()
loss = F.cross_entropy(logits, Y)
# 过大的正数 `exp()` 后会变成 `nan`,此函数内部会减去最大的正数
# 或者用 `prob = F.softmax(logits, dim=1)`

# backward pass
for p in parameters:
    p.grad = None
loss.backward()

# update
for p in parameters:
    p.data += -0.1 * p.grad
为了确定合适的 learning rate,可以选取 -1 ~ -0.001 中的值(10**torch.linspace(-3, 0, 1000)),计算效果然后绘图查看不稳定性。
训练到一定程度后可以降低 learning rate. 经过数千个循环后 loss 将低于 bigram 模型。但这个值低并不总是好的,可能发生过拟合。为了防止过拟合,我们会把数据分为训练集(~80%)、开放/验证集(~10%,用于调整超参数,如隐藏层大小、嵌入层大小、正则化强度)、测试集(~10%)三份。
在生成时:
out = []
context = [0]
while True:
    emb = C[torch.tensor([context])]
    h = torch.tanh(emb.view(1, -1) @ W1 + b1)
    logits = h @ W2 + b2
    probs = F.softmax(logits, dim=1)
    ix = torch.multinomial(probs, num_samples=1, generator=g).item()
    context = context[1:] + [ix]
    out.append(ix)
    if ix == 0:
        break
初始化
我们稍微测试一下,会发现最开始的 loss 相当大,因此考虑初始化时让 W1 是原本初始化的 0.2 倍,b1、W2 是原本的 0.01 倍,b2 为零。我们希望避免这样的情况:
以 ReLU 为例,如果一个神经元不会被任何一组数据激活(始终落在 $< 0$ 区域),则在训练时梯度会被归零,那么这个神经元的权重与偏置根本不会被改变,从满足这个条件开始可以视为这个神经元“已死”。对 tanh 等压缩函数,情况也类似(分布在 $\pm 1$ 附近)。
在较深、较复杂的网络中,不良的初始化可能导致根本无法训练。
那如何调这个参数呢?我们希望让 hpreact 大致是 $\mathcal N(0, 1)$ 的高斯分布。可以参考 Delving Deep into Rectifiers 论文。在 PyTorch 中可以调用 torch.nn.init 中的函数。参考以下表格:
| nonlinearity | gain |
|---|---|
| Linear / Identity | 1 |
| Conv{1,2,3}D | 1 |
| Sigmoid | 1 |
| Tanh | $5/3$ |
| ReLU | $\sqrt{2}$ |
| Leaky Relu | $\sqrt{2 / (1 + \text{negative\textunderscore slope}^2)}$ |
| SELU | $3/4$ |
$$\text{std} = \frac{\text{gain}}{\sqrt{\text{fan\textunderscore mode}}} \tag{Kaiming}$$
这里 fan_mode 我们取 fan_in,指一个层的输入节点数量。
W1 = torch.randn(...) * (5/3) / ((n_embd * block_size)**0.5)之后的技术,如 residue connections、使用 normalization layers、更先进的优化器,使得初始化可以不需要特别精细。
Batch Normalization
考虑 Batch Normalization:直接将 hpreact 归一化,这是可微的操作。
hpreact = (hpreact - hpreact.mean(0, keepdim=True)) / hpreact.std(0, keepdim=True)但是我们希望允许在非初始化阶段这个分布可以调整,因此额外引入矩阵,并将它们作为可训练的参数:
# bngain = torch.ones((1, n_hidden))
# bnbias = torch.zeros((1, n_hidden))

hpreact = bngain * ... + bnbias由于批次是随机选择的,logits 及 h 会抖动。也许这会被认为是某种缺陷,但实际上它起到的是积极效果,产生类似正则化的效果。
因为人们不希望前向传播的过程中 batch 的数据耦合起来,人们尝试弃用 batch normalization,转而采用其它归一化技术。
现在讨论这个问题:训练时使用 batch normalization,那我们在使用时如何对单个样本作预测呢?在训练后使用训练数据单独进行一次:
# calibrate the batch norm at the end of training
with torch.no_grad():
    emb = C[Xtr]
    embcat = emb.view(emb.shape[0], -1)
    hpreact = embcat @ W1 + b1
    bnmean = hpreact.mean(0, keepdim=True)
    bnstd = hpreact.std(0, keepdim=True)
另一种方法是在训练时以滑动平均的发生动态估算均值和标准差。
# bnmean_running = torch.zeros((1, n_hidden))
# bnstd_running = torch.ones((1, n_hidden))
bnmeani = hpreact.mean(0, keepdim=True)
bnstdi = hpreact.std(0, keepdim=True)
hpreact = bngain * (hpreact - bnmeani) / bnstdi + bnbias

with torch.no_grad():
    bnmean_running = 0.999 * bnmean_running + 0.001 * bnmeani
    bnstd_running = 0.999 * bnstd_running + 0.001 * bnstdi
最后作两点补充。为了防止 bnstdi 为零导致除零错误,有时会给它加上一个小的常数(如 1e-5);另外,这里偏置项是冗余的。
读者可以参考 PyTorch 的 Batch Normalization 文档:
class torch.nn.BatchNorm1d(num_features, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True, device=None, dtype=None, *, bias=True)$$y = \frac{x - \mathrm E[x]}{\sqrt{\mathrm{Var}[x] + \epsilon}} \ast \gamma + \beta$$