机器学习(二):分类;无监督学习
对应于教师 Lecture Notes 的 Lecture 3, 4.
分类
数学理解
与回归不同的是,分类的 label 是“类型”(category),这里用整数指代:
$$[c] = \set{1, \dots, c}$$
分类误差(classification error)是:
$$\min_\theta \frac 1 n \sum_{i=1}^n l_{\text{0-1}}(h_\theta(x_i), y_i)$$
这里 $l_{\text{0-1}}(y, y') = 1 - \delta_{y, y'}$,但这个损失函数不适合计算,因此通常使用一些代理损失函数(surrogate loss)$l$,要求的是 $l$ 光滑及 $l$ 小推出 $l_{\text{0-1}}$ 小。
概率模型
概率模型考虑的是软标签(soft label),即每个 $p(x)$ 在 $c-1$ 维单形中:
$$p(x) = (p_1(x), \dots, p_n(x)) \in \Delta^{c-1}$$
$$y \sim \mathrm{Categorical}(p(x))$$
我们需要选定一个将“逻辑值” (logits)$f_\theta$ 转为 $F_\theta$ 的函数。
$$ F_\theta: \mathcal X \to \Delta^{c-1} \\ f_\theta: \mathcal X \to \R^c $$
最常见的选择是 softmax,很多分类任务是比较有确定性的,指数强调了这一点:
$$\mathrm{softmax}(z) = \left(\frac{e^{z_1 / T}}{\sum e^{z_i / T}}, \dots, \frac{e^{z_c / T}}{\sum e^{z_i / T}}\right)$$
我们的优化目标就是:
$$\min_\theta \frac 1 n \sum_{i=1}^n d(p(x_i), F_\theta(x_i))$$
记 one-hot label $e_y = (0, \dots, 0, 1, 0, \dots, 0)$,我们实际上的优化目标是:
$$\min_\theta \frac 1 n \sum_{i=1}^n d(e_{y_i}, F_\theta(x_i))$$
就像回归中的标签也有噪声,只不过无偏一样,用 $e_{y_i}$ 没有什么问题。有时采取 label smoothing $(\delta / (c-1), \dots, \delta / (c-1), 1 - \delta, \delta / (c-1), \dots, \delta / (c-1))$.
这里的 $d$ 是“散度”(divergence),并不完全是距离。常用的是 KL 散度:
$$d_{\text{KL}}(p, q) = \sum p_i \log \frac{p_i}{q_i}$$
使用这个散度,优化目标就是:
$$\min -\frac 1 n \sum_{i=1}^n \left(\sum_{j=1}^c y_{i, j} \log F_j(x_i; \theta)\right)$$
如果用的是 one-hot label 就是:
$$\min -\frac 1 n \sum_{i=1}^n \log F_{y_i}(x_i; \theta)$$
这实际上就是极大似然估计(Maximize Likelihood Estimation, MLE)。极大似然估计是一个一般的方法:假设 $z \sim P_\theta$,生成了数据 $(z_1, \dots, z_n)$,看什么样的 $\theta$ 最有可能生成这组数据。我们要:
$$ \max \prod_{i=1}^n P_\theta(z_i) \iff \max \sum_{i=1}^n \underbrace{\log P_\theta(z_i)}_{\text{likelihood}} $$
现在热门的 Next-token prediction (NTP) 本质上也就是此:
$$\max_\theta \sum_{j=1}^n \sum_{i=1}^l \log F_{x_{i+1}^{(j)}}(x_{\leq i}^{(j)}; \theta)$$
几何模型:支持向量机
想象空间中有两团数据(相较于概率模型,几何模型无法自然地推广到多分类),我们用一个超平面把它们分开。超平面即:
$$H_\theta = \set{x | w^\top x + b = 0}$$
除了将两团分开外,还有一个直观是:扰动后数据仍不容易越过超平面。因此考虑最大化 $\min d(x_i, H_\theta)$(不去最大化 $\frac 1 n \sum d(x_i, H_\theta)$,因为这对于不均衡的数据等情况结果不太合理)。
我们的优化目标即($y_i = \pm 1$):
$$\max_{w \in \mathbb S^{d-1}, b} \min_i |w^\top x_i + b| \text{ s.t. } (w^\top x_i + b) y_i \geq 0$$
令 $t = \min_i |w^\top x_i + b|$,那么(假设线性可分)等价于:
$$\max_{w \in \mathbb S^{d-1}, b} t \text{ s.t. } (w^\top x_i + b) y_i \geq t$$
令 $\tilde w = w / t, \tilde b = b / t$,即:
$$\min_{\tilde w, \tilde b} \lVert \tilde w \rVert^2 \text{ s.t. } \underbrace{(\tilde w x_i + \tilde b) y_i}_{\text{confidence}} \geq 1$$
我们称 $(\hat w x_i + \hat b) y_i = 1$ 的点为支持向量(support vector),它们是真正决定结果的点。
直观上,更少的支持向量能带来更好的泛化能力。
如果数据不线性可分,则有如下两种方法:
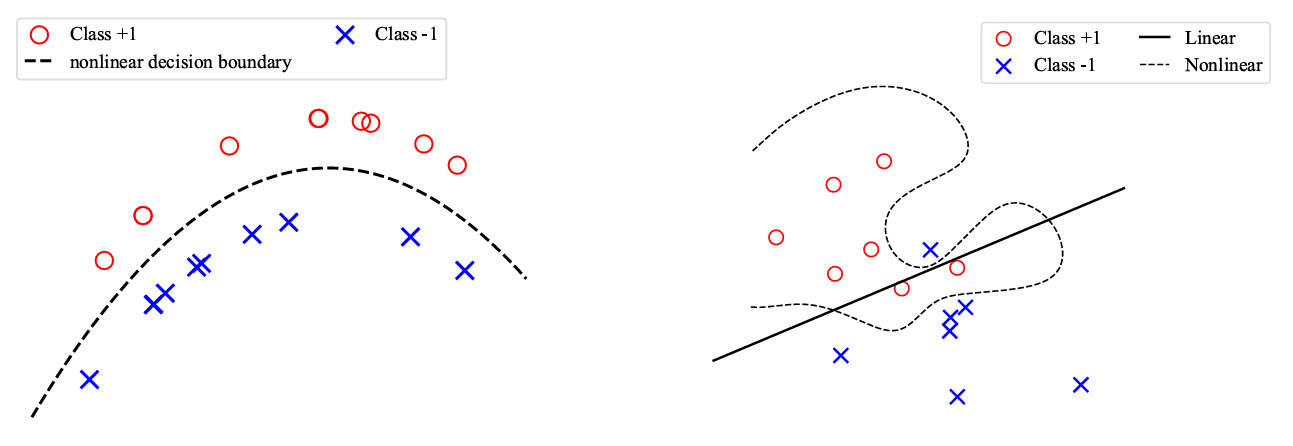
第一种是非线性地分,放到更大的特征空间中用支持向量机分开。这也是核方法在机器学习中被推动的重要因素。记某个 complexity $\Omega: \mathcal F \to \R_{\geq 0}$,所做就是:
$$\min \Omega(f) \text{ s.t. } f(x)y_i \geq 1$$
第二种就是 soft margin,允许少量数据有错。
$$\min \Omega(f) + \frac \lambda n \sum_{i=1}^n \xi_i \text{ s.t. } f(x_i)y_i \geq 1 - \xi_i, \, \xi_i \geq 0$$
这等价于如下无约束问题:
$$\min \frac 1 \lambda \Omega(f) + \frac 1 n \sum_{i=1}^n \max(0, 1 - f(x_i) y_i)$$
我们不妨将 $\max(0, 1 - f(x_i) y_i)$ 写成 $l(f(x_i) y_i)$,就可以写成熟悉的形式:
$$\min_f \frac 1 n \sum_i l(f(x_i) y_i) + \tilde \lambda \Omega(f)$$
我们可以形成的一般准则(margin/confidence-based principle)是:confidence 高时应降低惩罚。
这里损失函数有很多种选择:
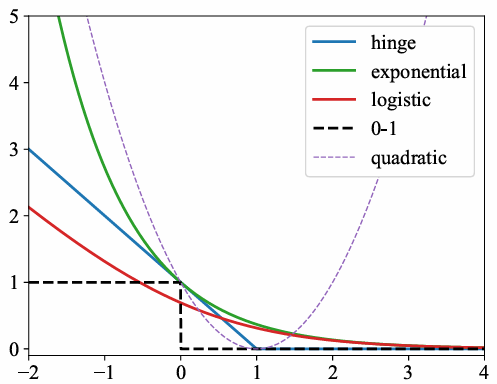
这里 logistic 是:
$$l(z) = \log(1 + e^{-z}) = \begin{cases} e^{-z} & z \gg 1 \cr -z & z \ll 1 \end{cases}$$
无监督学习
数学理解
无监督学习有两类,传统的那一类 discriminative 是对于分布 $\rho^\ast$ 生成 $x_i \stackrel {\text{iid}} \sim \rho^\ast$,根据 $x_1, \dots, x_n$ 推导 $\rho^\ast$ 的某些性质;另一类 generative 则是生成某些 $\{\tilde x_j\}_{j=1}^m$.
第一类中方法有:密度估计(density estimation)希望得到 $\hat \rho_n \approx \rho^\ast$;降维(dimension reduction)希望找到低维结构;聚类(clustering)。
密度估计
第一种方法是直方图(histogram estimate)。假设 $x_i \in [0, 1]^d = I$,将 $I$ 划分成 $h^d$ 个网格 $I_j$,每个网格有 $n_j$ 个样本点。那么平凡地:
$$\hat \rho_h(x) = \sum_{j=1}^m \frac{n_j}{h^d n} \mathbf 1_{I_j}(x)$$
第二种方法是核密度估计(kernel density estimator, KDE)。$\hat \rho_n(x) = \sum_i \delta(x - x_i)$ 在某种意义下可以趋近于 $\rho^\ast$.
我们把 $\delta$ 换成某个 $K_h$. 定义 $K$ 是 smoothing kernel 如果 $K \geq 0$、积分为 $1$ 及对称 $K(x) = K(-x)$,常见的选取有 Box、Triangular 及 Gaussian;然后令 $K_h(x) = h^{-d} K(x / h)$.
现在来估计误差,使用 variance-bias 分解($\mathbb E[Z^2] = (\mathbb EZ)^2 + \mathbb E[(Z - \mathbb EZ)^2]$),设 $\rho_h(x) = \mathbb E_S[\hat \rho_h(x)]$:
$$\mathbb E_S[(\hat \rho_h - \rho^\ast)^2] = (\underbrace{\mathbb E_S(\rho_h - \rho^\ast))^2}_{\text{bias}} + \mathrm{Var}(\hat \rho_h)$$
则这里 bias 是(使用积分为 $1$ 与对称性):
$$ \begin{split} \text{bias} &= \mathbb E_{x \sim \rho^\ast}[K_h(x - x')] \cr &= \int K_h(x - x') \rho^\ast(x') \mathrm dx' \cr &= \int K(z) \rho^\ast(x - hz) \mathrm dz \cr &= \int K(z) (\rho^\ast(x) - h\braket{\nabla \rho^\ast(x), z} + \frac{h^2}2 z^\top \nabla^2 \rho^\ast(x) + o(h^2)) \mathrm dz \cr &= \rho^\ast(x) + C_1h + C_2h^2 + o(h^2) \cr &\eqsim h^4 \end{split} $$
$$ \begin{split} \text{variance} &= \frac 1 {nh^d} \int K^2(z) \rho^\ast(x + hz) \mathrm dz \cr &\leq \frac{c_3}{nh^d} \end{split} $$
故而,我们希望 $\min (h^4 + \frac 1 {hd^n})$,大概希望 $\hat h_{\text{opt}} = cn^{- 1 / (d+4)}$,这里的常数我们不知道,可以用一些小模型来尝试。又,这里可知此方法有维数灾难,只适合低维($\leq 3$)。
降维
降维依赖于:假设数据在某个低维子流形上。
线性降维的经典方法是主成分分析(PCA, principal component analysis)。
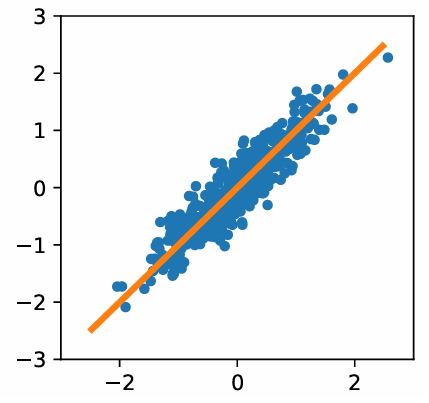
先归一化到重心是原点,考虑投影到 $1$ 维,计算投影的方差:
$$\max_{\lVert w\rVert = 1} \frac 1 n \sum_{i=1}^n (x_i^\top w)^2$$
令 $\hat \Sigma = \frac 1 n \sum x_i x_i^\top$,即:
$$\max_{\lVert w\rVert = 1} w^\top \hat \Sigma w$$
这个最大值是最大特征值,此时 $w$ 是对应特征向量。
把这个方法推广到 $k$ 维,设 $W = (w_1, \dots, w_k) \in \R^{n \times k}$,假设 $W^\top W = I_k$,则:
$$\max_{W^\top W = I_k} \sum_{\alpha=1}^k w_\alpha^\top \hat \Sigma w_\alpha$$
非线性降维的方法在今日看大多不好用,因为非线性,难以从降维结果推测原本的性质。
现在来看随机投影(random projection),想法是找一个 $f: \R^d \to \R^k$ 大致满足:
$$1 - \varepsilon \leq \frac{\lVert f(x_i) - f(x_j) \rVert}{\lVert x_i - x_j \rVert} \leq 1 + \varepsilon$$
后来人们发现,实际上只要取成:
$$f(x) = \frac 1 {\sqrt k} Wx, W \in \R^{k \times d}, w_{ij} \sim N(0, 1)$$
设 $x_1, \dots, x_n$ 是 $\R^d$ 中样本,给定 $0 < \delta < 1$,令 $k_\varepsilon = 6\log(2n/\delta)/\varepsilon^2$,对于 $k \geq k_\varepsilon$,在 $W$ 的随机采样上有 $1 - \delta$ 的概率:
$$\max_{i \in [n]} \left|\frac{\lVert \frac 1 {\sqrt k} Wx_i \rVert_2^2}{\lVert x_i \rVert_2^2} - 1\right| \leq \varepsilon$$
不失一般性假设 $\lVert x_i \rVert_2 = 1$,设 $W = (w_1, \dots, w_k)^\top$,则 $w_j^\top x \sim N(0, 1)$,有:
$$\mathbb E[\lVert \frac 1 {\sqrt k} Wx \rVert_2^2] = \frac 1 k \sum_{j=1}^k \mathbb E[|w_j^\top x|^2] = 1$$
使用集中不等式,有:
$$P\left(\left|\frac 1 k \sum_{j=1}^k |w_j^\top x|^2 - 1\right| \geq \varepsilon\right) \leq 2e^{-k\varepsilon^2/6}$$
$$P\left(\max_{i \in [n]} \left|\frac 1 k \sum_{j=1}^k |w_j^\top x|^2 - 1\right| \geq \varepsilon\right) \leq n2e^{-k\varepsilon^2/6}$$
让 $2ne^{-k\varepsilon^2/6} \leq \delta$ 即得原定理。