机器学习(一):概论与线性方法
本文内容来自于《机器学习数学导引》课程听课笔记。这一部分(除核方法外)为第一次小测涉及的内容,对应于教师 Lecture Notes 的 Lecture 1, 2.
导论
数学理解
我们来从数学角度理解机器学习中的监督学习。我们希望知道一个目标函数:
$$f^\ast: \mathcal X \to \mathcal Y$$
我们通过数据和先验知识(如目标函数光滑)去找函数 $\hat f$ 使得:
$$\hat f \approx f^\ast$$
考虑训练集 $S = \set{(x_i, y_i)}$,定义:
$$\underbrace{y_i} _{\text{label}} = \underbrace{f^\ast(x_i)} _{\text{target function}} + \underbrace{\varepsilon_i} _{\text{noise}}$$
典型的 $y_i$ 有两种:实值,此时称模型为回归(regression);类型,此时称模型为分类(classification)。
考虑预测同学的成绩,虽然可以表达成实值,但我们并不关心小数点两位那么精确的值,同时也不认为我们能做到如此精确的估计。考虑将成绩分为 $1, \dots, 10$ 十类,实际中建模成分类任务可能会比直接做回归效果更好。
考虑学习任务的难度可能来自哪里。这一方面会受到是否线性的影响;另一方面受到维数的影响。一维数据可以肉眼看出来,但图像识别(早期重要的体现机器学习价值的例子)的输入可能是 $224 \times 224 \times 3$ 维的,无法用传统统计方法处理。由此看维数是重要的区分传统方法和机器学习的依据。
方法论
Step 1 是选择一个假设空间/带参数模型族(hypothesis space / model class):
$$\mathcal H_m = \set{f_\theta: \mathcal X \to \mathcal Y | \theta \in \R^m}$$
其内容可能是线性函数 $b + w^\top x \, (\theta = (b, w))$、基展开 $\sum b_j \varphi_j(x)$、神经网络等,不一而足。
Step 2.0 是建立一个优化问题。确定度量差异的损失函数(loss function)$l$,然后最小化经验风险(empirical risk)就是我们的训练目标(optimization objective)。
$$\min_\theta \hat R(\theta) \coloneqq \frac 1 n \sum_{i=1}^n l(f(x_i), y_i)$$
为了编码先验知识(如 $f^\ast$ 的光滑性),通常加上正则化项:
$$\min_\theta J(\theta) \coloneqq \hat R(\theta) + \lambda \underbrace{P(f_\theta)}_{\text{penalty}}$$
Step 2.1 是设计优化器。如梯度下降迭代:
$$\theta_{k+1} = \theta_k - \eta \nabla J(\theta_k)$$
在公司中,Step 1 会对应一个架构/模型组,Step 2 对应一个优化器组。这两个组有时合并,因为取决于算力,架构设计时需要让收敛更快。
在整个过程中,Step 1 与 2 门槛最高,但核心是数据,清洗数据带来的效果可能比优化架构有用很多。
对公司来说还有 Step 3,对应评测部门。数据集被分成三部分:训练集⽤于拟合模型参数,即最⼩化训练⽬标;验证集(validation set)⽤于选择超参数(hyperparameter)(如正则化强度等)、模型结构、训练轮数等;测试集只⽤于最终报告泛化性能。将测试集放进模型选择与训练过程会使之不再可信。
记(用 $\leftarrow$ 表示赋值,用 $\hat ~$ 表示从数据学到的):
$$\hat f \leftarrow \argmin_{f \in \mathcal H_m} \hat R(f)$$
我们定义泛化误差/期望损失(generalization error / expected risk):
$$R(f) \coloneqq \mathbb E_{x \sim \rho}[l(f(x), f^\ast(x))]$$
这里我们假设存在一个客观存在的分布 $\rho$,并有 $x_i \stackrel {\text {iid}} \sim \rho$. 无法直接计算泛化误差,因此取测试集 $S_{\text{test}} = \set{(x_j, f^\ast(x_j))}$ 满足 $\tilde x_j \stackrel {\text {iid}} \sim \rho$,定义测试误差(test error)是:
$$ \begin{split} \hat R_{\text{test}}(f) &\coloneqq \frac 1 {n_{\text{test}}} \sum_{j=1}^{n_{\text{test}}} l(f(\tilde x_j), \tilde y_j) \\ &= R(f) \end{split} $$
这就是 Monte Carlo 近似。记 $z_i = l(f(\tilde x_i), \tilde y_i)$,$\mu = \mathbb E[z]$,由于独立同分布,
$$ \begin{split} \mathbb E(R(f) - \hat R(f))^2 &= \mathbb E\left(\frac 1 N \sum (z_j - \mu)\right)^2 \cr &= \frac 1 {N^2} \sum_{i \neq j} \mathbb E[(z_i - \mu)(z_j - \mu)] + \frac 1 {N^2} \sum \mathbb E[(z_i - \mu)^2] \cr &= \frac 1 {N^2} \sum_{i \neq j} \mathbb E[z_i - \mu] \mathbb E[z_j - \mu] + \frac 1 {N^2} \sum \mathbb E[(z_i - \mu)^2] \cr &= \frac 1 {N^2} \sum \mathbb E[(z_i - \mu)^2] \cr &= \frac {\mathrm{Var}(z)} N \end{split} $$
误差分解
记假设空间 $\mathcal H_m = \set{f_\theta | \theta \in \R^m}$ 内最优:
$$f_H^\ast \leftarrow \argmin_{f \in \mathcal H_m} R(f)$$
则可以作分解(有时设数据没有噪声,$R(f^\ast) = 0$):
$$R(\hat f) - R(f^\ast) = \underbrace{R(\hat f) - R(f_H^\ast)} _{\text{estimation error}} + \underbrace{R(f_H^\ast) - R(f^\ast)} _{\text{approximation error}}$$
这里估计误差来自于有限训练数据和优化过程,记作 $E_H(n, m)$,一般来说会随 $m$ 增大(表达能力增强后有更大的风险得到复杂而非真实的函数);近似误差来自空间 $\mathcal H_m$ 的表达能力,记作 $A_H(m)$;总误差记为 $\mathcal E(n, m)$.
增加数据主要有助于降低估计误差,而扩大模型的表达能力主要有助于降低近似误差。朴素的看法认为误差会随 capacity $m$ 呈 U 型曲线,因此正则化作用是惩罚复杂性。现代深度学习会更复杂,如在 capacity 足够高时会出现二次下降。
成本
我们希望在 $\min_{m, n} R_H(m, n)$ 的同时让成本 $C_H(m, n) \leq B$,不妨考察简化的例子:
$$ \begin{cases} C_H(m, n) = n \cdot m \cdot \alpha_H \\ R_H(m, n) = \frac 1 {m^\alpha} + \frac 1 {n^\beta} & \text{(deepmind scaling law)} \end{cases} $$
$$\begin{cases} \min \frac 1 {m^\alpha} + \frac 1 {n^\beta} \cr m \cdot n \leq c \end{cases} \implies \begin{cases} m \sim C^{\frac \beta {\alpha+\beta}} \cr n \sim C^{\frac \alpha {\alpha+\beta}} \end{cases}$$
现代来看,我们可以设计 $R$,从而给出对应 scaling law 结果,可以预测增加若干预算能有多少优化。由此我们离开了古法的“炼丹”情景。
泛化
我们希望从有限的数据推广到无限的数据。考察:
$$ \begin{split} \hat f(x) - f^\ast(x) &= \hat f(x) - \hat f(x_k) + \hat f(x_k) - f^\ast(x_k) + f^\ast(x_k) - f^\ast(x) \cr &\leq \mathrm{Lip}(f) |x - x_k| + \mathrm{Lip}(f^\ast) |x - x_k| + \delta_k \end{split} $$
假设数据在 $[0, 1]$ 上均匀,有 $\min_j |x - x_j| \sim \frac 1 n$;对 $X = [0, 1]^d$ 则(考察网格情况及使用 sphere packing argument):
$$\min_j |x - x_j| \sim n^{-\frac 1 d} = \varepsilon$$
这会使得 $n_\varepsilon = \Omega(\varepsilon^{-d})$,假若希望 $\varepsilon \leq 0.1$,对 $d = 150000$ 就需要 $10^{150000}$ 的数据,这是不可接受的。这个现象称为维数灾难(curse of dimensionality, CoD)。这是因为,在高维单位球面上有现象:点的距离几乎都相同;向量几乎都正交;体积集中在边界上。
为了避免维数灾难,我们需要利用一些数据的结构。如 $s$ 阶可微的函数可以带来:
$$|\hat f(x) - f^\ast(x)| \sim n^{-\frac s d}$$
如果假设空间是分片常值函数(在实际中确有,如 K-nearest neighbour (KNN)),想要去拟合线性函数,则读者可验证也会造成维数灾难。
线性回归
线性模型
线性方法比较 robust,同时完全可解释、可计算,因此学习时不能当黑箱来看。
线性方法的假设空间即:
$$\mathcal H = \set{\mathbf x \mapsto \beta^\top \mathbf x + \beta_0 | \beta \in \R^d, \beta_0 \in \R}$$
有时我们会作简化,将它看成:
$$ \underbrace{\begin{pmatrix} \beta^\top & \beta_0 \end{pmatrix}} _\beta \underbrace{\begin{pmatrix} \mathbf x \cr 1 \end{pmatrix}} _{\mathbf x} $$
$$\mathcal H = \set{\mathbf x \mapsto \beta^\top \mathbf x | \beta \in \R^d}$$
我们作以下记号约定:
$$ X = (\mathbf x_1, \dots, \mathbf x_n)^\top \in \R^{n \times d} \\ \mathbf y = (y_1, \dots, y_n)^\top $$
最小二乘法
最小二乘法(Ordinary Least Squares, OLS)使用以下经验误差。注意使用 square loss 并不是天然的:这会带来解析解,在噪声 $\varepsilon_i \sim N(0, \sigma^2)$ 时适用,但在 $P(|\varepsilon_i| \geq R) \propto R^{-\beta}$ 这样尾部较大的情形可能不适用。
$$\hat R(\beta) \coloneqq \frac 1 {2n} \lVert\mathbf X\beta - \mathbf y\rVert^2$$
将其最小化只需要通过让梯度为零:
$$\nabla \hat R(\beta) = \frac 1 n X^\top (X\beta - \mathbf y) = 0$$
其解即下式(其中 $X^\top X$ 是 Gram 矩阵):
$$\hat \beta_{\text{OLS}} = (X^\top X)^{-1} X^\top \mathbf y$$
但实际中几乎不会直接用这个解。一方面需要 Gram 矩阵可逆,这需要样本数大于维数。另一方面,这个解对标签噪声(label noise)和异常值敏感,因此需要改为:
$$\min_\beta \hat R(\beta) + \lambda r(\beta)$$
所谓“调参”,就是调整超参数(这里只有 $\lambda$)。这没有什么一般的方法,但可以参考一些原则:
- $n$ 变大,左边更接近真实,应当 $\lambda$ 变小
- 对大模型来说假设有一个 scaling law $\lambda \propto n^{-r}$,先在小模型上拟合然后推广
- 准备一个验证集,设 $\beta(\lambda)$ 是一个 $\lambda$ 对应的 $\argmax$, $$\lambda \leftarrow \argmin \frac 1 {|n_{\text{val}}|} \sum |\mathbf x\beta(\lambda) - y|^2$$
岭回归
岭回归(Ridge Regression)是指使用 $\ell_2$ 正则化:
$$\min_\beta \frac 1 n \lVert X\beta - \mathbf y\rVert^2 + \lambda \lVert \beta \rVert^2$$
$$\hat \beta_\lambda = \left(\frac 1 n X^\top X + \lambda I_d\right)^{-1} \frac 1 n X^\top \mathbf y$$
假设 $\varepsilon_i \sim N(0, \sigma^2)$,并令 $\Sigma = X^\top X / n$ 及 $\Delta = \beta^\ast - \hat \beta_\lambda$,则:
$$\hat \beta_\lambda = (\Sigma + \lambda)^{-1} \Sigma \beta^\ast + (\Sigma + \lambda)^{-1} \frac 1 n X^\top \varepsilon$$
$$\Delta = \lambda (\Sigma + \lambda)^{-1} \beta^\ast - (\Sigma + \lambda)^{-1} \frac 1 n X^\top \varepsilon$$
于是有下式,可以发现通常正则化增⼤时,偏差增⼤,⽅差减⼩,因此存在一个权衡。
$$ \begin{split} \mathbb E \lVert \Delta \rVert^2 &= \lambda^2 \beta^\ast (\Sigma + \lambda)^{-2} \beta^\ast + \frac 1 {n^2} \mathbb E[\varepsilon^\top X (\Sigma + \lambda)^{-2} X^\top \varepsilon] \cr &= \lambda^2 \beta^\ast (\Sigma + \lambda)^{-2} \beta^\ast + \frac{\sigma^2}{n} \mathrm{tr}[(\Sigma + \lambda)^{-2} \Sigma] \end{split} $$
作特征值分解,研究特征方向的影响:
$$ \Sigma = \sum_{j=1}^d \lambda_j u_j u_j^\top \\ \beta^\ast = \sum_{j=1}^d \beta_j^\ast u_j $$
$$\mathbb E \lVert \Delta \rVert^2 = \lambda^2 \sum_{j=1}^d \frac{|\beta_j^\ast|^2}{(\lambda_j + \lambda)^2} + \frac{\sigma^2}{n} \sum_{j=1}^d \frac{\lambda_j}{(\lambda_j + \lambda)^2}$$
假设各向同性 $\lambda_i = 1$,则算得:
$$\lambda_{\text{opt}} \propto \frac 1 n$$
另外可分析得绝大部分误差来自于 $\lambda_j \ll \lambda$ 的方向的噪声。这样看正则化可以降低该部分误差。
Lasso 回归
思考上面在使用 $\lambda \lVert \beta \rVert_2^q$ 时为什么选取 $q = 2$?一方面是为了更好算,另一方面是为了让量纲一致。
考虑 $\ell_0$ 正则化(相当于考察稀疏性(sparsity)):
$$\lVert\beta\rVert_0 \coloneqq \#\set{\beta_j \neq 0 | j \in [d]}$$
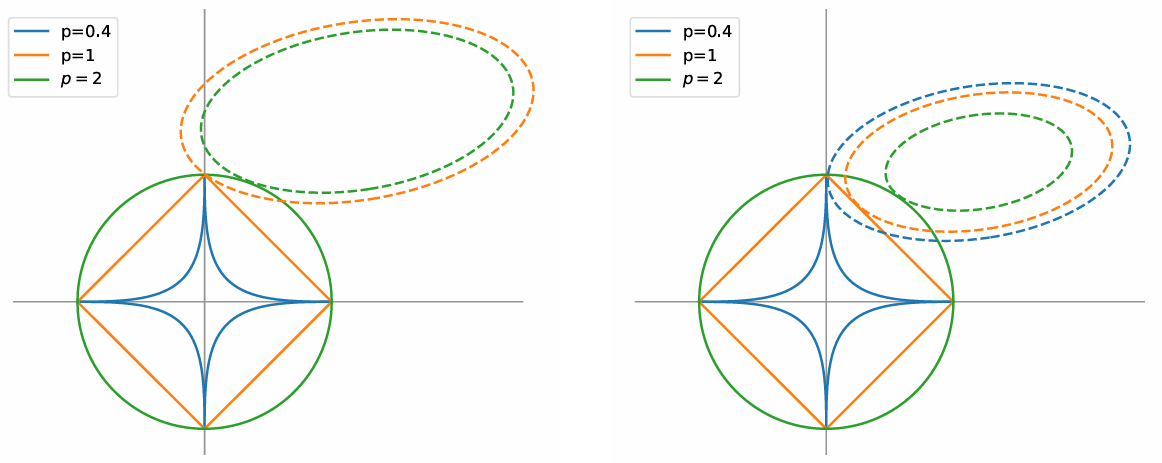
最终会有 $\lVert\beta\rVert_0 \ll d$,这使得结果有较好的可解释性。但 $\ell_0$ 正则化不连续且非凸,无法梯度下降,因此考虑用一般的 $p$ norm,由于 $p \geq 1$ 时函数才凸,考虑 $\ell_1$ 正则化,得到的是 Lasso 回归(Least Absolute Shrinkage and Selection Operator, Lasso)。
一般用 $\ell_1$ 正则化的时候不会平方,一方面可能因为实际中会把数据归一化,另一方面 $\ell_0$ 正则化是没有量纲的,我们本质上考虑的是 $\ell_0$ 而不是 $\lambda \lVert \beta \rVert_2^2$.
可解释是指对于人类可解释,如 $\beta = (1, 0, 0, 0)$ 误差 $0.02$,$\beta = (0.6, 0.15, 0.15, 0.1)$ 误差 $0.01$,则人类心智偏向于前者。也许对 AI 来说并不如此。
用一维 Lasso 考察为什么会让 $\beta$ 稀疏:
$$S_\lambda(y) = \argmin_\beta \frac 1 2 (\beta - y)^2 + \lambda |\beta|$$
$$ S_\lambda(y) = \begin{cases} y + \lambda & y < -\lambda \cr y - \lambda & y > \lambda \cr 0 & \text{otherwise} \end{cases} $$
因此,较小的参数会直接变为零。反观一维 Ridge 则是收缩:
$$\hat \beta_{\text{ridge}} = \frac{y}{\lambda + 1}$$
可参考如下几何直观。可见只需要让单位圆是尖的。实际中有时把 $p = 1$ 换成 $0.5, 0.6$ 会更好用。
压缩感知
Compressive sensing 是说,数据在某个 $d$ 维空间中,但我们的数据量 $n \ll d$. 考察:
$$X\beta = \mathbf y, \quad X \in \R^{n \times d}$$
这个方程可能有无穷多的解,为了选出有意义的解,要求 $\beta$ 稀疏:
$$\min \lVert\beta\rVert_0 \text{ s.t. } X\beta = \mathbf y \tag{*}$$
当 $\lVert\beta\rVert_0 \leq k$ 时称 $\beta$ 为 $k$-稀疏的。为了能够唯一地恢复信号,我们希望:
$$\lVert X\beta - \mathbf y\rVert = \lVert X(\beta - \beta^\ast)\rVert = \lVert\beta - \beta^\ast\rVert$$
称 $X$ 满足关于常量 $\delta_s \in (0, 1)$ 阶 $s$ 的 RIP 性质,如果对所有 $s$-稀疏的向量 $\beta$ 都有:
$$(1 - \delta_s) \lVert\beta\rVert_2^2 \leq \lVert X\beta\rVert_2^2 \leq (1 + \delta_s) \lVert\beta\rVert_2^2$$
设 $\beta_0$ 是问题 $(\ast)$ 的解,$\beta_1$ 是其 $\ell_1$ 版本的解。若 $X$ 满足 $2s$ 阶 RIP,且 $\delta_{2s} < \sqrt 2 - 1$,则有:
$$\lVert\beta_1 - \beta_0\rVert_1 \leq C_0 \, \lVert\beta_0 - T_s(\beta_0)\rVert_1$$
其中 $T_s$ 是 top-$s$ 稀疏近似,即保留绝对值最大的 $s$ 个分量,其余分量置零。
核方法
特征与核
将线性方法推广到非线性时一个方法是引入基函数:
$$f_\theta(\mathbf x) = \theta^\top \phi(\mathbf x)$$
做机器学习的人进一步把它看成:
$$f_\theta(\mathbf x) = \braket{\theta, \phi(\mathbf x)}$$
这里 $\phi$ 称为特征映射(feature map),将数据打到某个 Hilbert 空间 $\mathcal H$,
$$\phi: \mathcal X \to \underbrace{\mathcal H}_{\text{feature space}}$$
“特征”的直观在于,我们看到人的时候并不是看对应的像素点,而是考虑纹理、局部形状;手之类的特征。于是建立如下的总体图景:
$$X \xrightarrow{\phi} \mathcal H \xrightarrow{\text{linear}} \R$$
$$\min_\theta \frac 1 n \sum_{i=1}^n (\braket{\phi(x_i), \theta} - y_i)^2 + \lambda \lVert\theta\rVert^2$$
但在特征空间 $m \gg 1$ 时,朴素地按此式计算有很高的成本,以下的 kernel trick 给出了更好的算法。
最优解一定在如下 $\phi(\mathbf x_i)$ 张成空间中:
$$V_n = \operatorname{span}\set{\phi(\mathbf x_1), \dots, \phi(\mathbf x_n)}$$
考虑正交分解 $\theta = \theta^\parallel + \theta^\perp$,
$$f_\theta(\mathbf x_i) = \braket{\theta, \phi(\mathbf x_i)} = \braket{\theta^\parallel, \phi(\mathbf x_i)} = f_{\theta^\parallel}(\mathbf x_i)$$
因此我们可以只考虑:
$$\hat\theta = \sum_{i=1}^n \alpha_i \phi(\mathbf x_i)$$
我们定义以下核函数,并令矩阵 $K_{ij} = k(\mathbf x_i, \mathbf x_j)$,
$$k(\mathbf x_i, \mathbf x_j) \coloneqq \braket{\phi(\mathbf x_i), \phi(\mathbf x_j)}$$
因此只需要考虑以下问题(Kernel Ridge Regression, KRR):
$$\min_{\alpha \in \R^n} \frac 1 n \lVert K\alpha - \mathbf y \rVert^2 + \lambda \alpha^\top K\alpha$$
核函数与半正定
我们称函数 $k: \mathcal X \times \mathcal X$ 是核,如果存在特征映射 $\phi$ 使得:
$$k(\mathbf x, \mathbf x') = \braket{\phi(\mathbf x), \phi(\mathbf x')}$$
称 $k$ 是半正定(positive semidefinite, PSD)的,如果它对称且恒有:
$$\sum_{i, j = 1}^n \alpha_i \alpha_j k(\mathbf x, \mathbf x') \geq 0$$
对任意半正定函数 $k$ 存在空间 $\mathcal H$ 及特征映射 $\phi$ 使得 $k$ 是核。
常见的核函数有:
| 名称 | 表达式 |
|---|---|
| 多项式核 | $(1 + \mathbf{x^\top x'})^s$ |
| Gaussian 核 | $\exp(-\lVert\mathbf{x - x'}\rVert^2 / 2\sigma^2)$ |
| Laplace 核 | $\exp(-\lVert\mathbf{x - x'}\rVert_2 / \sigma)$ |
例如,一维、$\sigma = 1$ 的 Gaussian 核对应的特征映射:
$$\phi(x) = e^{-\frac{x^2}{2}} \left(1, x, \frac 1 {\sqrt {2!}} x^2, \frac 1 {\sqrt {3!}} x^3, \dots\right)$$
随机特征方法
可以算得 KRR 的解析解是:
$$\hat \alpha = (K + n\lambda I)^{-1} y$$
在 1985-1995,机器学习主要是做浅层神经网络,但是因为非凸所以优化很复杂,于是 1995-2015 做核方法。大约 2005-2006 年,随互联网发展,$n$ 达到 $10^6$ 量级,而上面的解需要 $O(n^3)$ 的计算与 $O(n^2)$ 的存储,这是不可接受的。
在数值线性代数中,优化靠的是稀疏矩阵,在这里我们不妨考虑:
$$k(\mathbf x, \mathbf x') = \mathbb E_{\omega \sim \pi}[\varphi(\mathbf x; \omega_j) \varphi(\mathbf x'; \omega_j)]$$
这里 $\varphi: \mathcal X \times \Omega \to \R$,$\pi$ 是 $\Omega$ 上的概率测度。
我们可以做 Monte Carlo 离散:
$$k(\mathbf x, \mathbf x') \approx \frac 1 m \sum_{j=1}^m \varphi(\mathbf x; \omega_j) \varphi(\mathbf x'; \omega_j)$$
随机特征模型(Random Feature Model)即:
$$f(\mathbf x; \beta) = \frac 1 m \sum_{j=1}^m \beta_j \varphi(\mathbf x; \omega_j)$$
对应的岭回归问题是:
$$\min_\beta \frac 1 {2n} \sum_{i=1}^n \left(\frac 1 m \sum_{j=1}^m \beta_j \varphi(\mathbf x_i; \omega_j) - y_i\right)^2 + \frac \lambda {2m} \lVert\beta\rVert_2^2$$
记 $\Phi = (\varphi(\mathbf x_i; \omega_j)) \in \R^{n \times m}$,则解是:
$$\hat \beta = m (\Phi^\top \Phi + n\lambda I)^{-1} \Phi^\top y$$
这个方法可以解释为核方法的随机特征近似(random feature approximation),只需要 $O(m^2n)$ 的计算与 $O(mn)$ 的存储,对 $m \ll n$ 优化相当显著。
考虑平移不变(translation invariant)的核,即形如 $k(\mathbf x, \mathbf x') = \kappa(\mathbf{x - x'})$ 的核。
采取如下 Fourier 变换约定:
$$ \hat f(x) = \frac 1 {(2\pi)^{d/2}} \int f(x) e^{-\mathrm i\omega x} \mathrm d\omega \\ \check g(x) = \frac 1 {(2\pi)^{d/2}} \int g(x) e^{\mathrm i\omega x} \mathrm d\omega $$
对于 $\hat \kappa(\omega) \geq 0$,可以让 $\hat \kappa(\omega) / c$ 是一个密度,
$$k(x, x') = (\hat \kappa)^\vee(x - x') = \frac c {(2\pi)^{d/2}} \int \frac{\hat \kappa(\omega)}{c} e^{\mathrm i\omega x} \cdot \overline{e^{\mathrm i\omega x'}} \mathrm d\omega$$
设这个密度决定的分布 $\pi$,则上式即:
$$\frac c {(2\pi)^{d/2}} \mathbb E_{\omega \sim \pi}[e^{\mathrm i\omega x} \cdot \overline{e^{\mathrm i\omega x'}}]$$
于是有随机 Fourier 特征(random Fourier features, RFFs):
$$\varphi(\mathbf x; \omega) = e^{\mathrm i\omega\mathbf x}$$
例如说,对 Gaussian kernel,其 Fourier 变换是它自身,对应的分布 $\pi$ 是高斯分布。
回顾核方法将基函数变成核,再将核拆成随机特征。尽管数学上这两个操作互逆,其 modeling 不同:一开始的特征是人类认为的那些特征,而之后的则是一些人类无法想象的“随机特征”。
回忆 Gaussian kernel $\exp(-\lVert\mathbf{x - x'}\rVert^2 / 2\sigma^2)$,在 $\lVert\mathbf{x - x'}\rVert \ll \sigma$ 时,它约等于 $1 - \lVert\mathbf{x - x'}\rVert^2 / 2\sigma^2$,反之 $\gg$ 则约等于零。直观上这说的是只关心临近的点。