《数据结构与算法》期中复习笔记
本文为复习《数据结构与算法A》,参考其仓库;读者也可参考 Steven S. Skiena The Algorithm Design Manual 及 OI Wiki 对应内容(含有动图)。
概论
数据结构的研究内容包括数据的逻辑结构、数据的存储结构与在此结构上定义的运算(算法)。抽象数据类型(ADT)不关心存储结构,我们用有向图来表示。
数据的四种基本存储方式是顺序存储、链接存储、索引存储、散列存储。
算法的四个性质是通用性、有效性(每条指令能被确切执行)、确定性(每步之后下一步怎么走有明确指示)、有穷性(有限步内结束)。五个特性是有穷性、确定性(每步含义唯一)、可行性(每步都能机械执行)、 输入(零个或多个)、输出(一个或多个)。
渐进分析方法中,我们定义 $f(n) = O(g(n))$,如果存在正常数 $c$ 和 $N$,对 $n > N$ 均有 $f(n) \leq c g(n)$.
这控制的是上界,控制下界的记号是 $\Omega$;如果有 $c_1 g(n) \leq f(n) \leq c_2 g(n)$ 则称 $f(n) = \Theta(g(n))$.
一个算法的时间复杂度还有“最佳”、“最差”和“平均”的区分。
线性表
线性表中要求元素之间有“前驱”/“后继”的逻辑关系,元素的相对位置是线性的;每一个元素有相同的数据类型和长度。
顺序表
按顺序方式存储的线性表称为顺序表(array-based list),允许以 $O(1)$ 随机存取。一个工程版1实现例子如下:
#pragma once

#include <cstddef>
#include <limits>
#include <optional>
#include <stdexcept>
#include <type_traits>
#include <utility>

namespace dsa {

template <typename T>
class array_list {
public:
    using value_type = T;
    using size_type = std::size_t;

    // 因为需要调用 new T[n]
    static_assert(std::is_default_constructible<T>::value,
                  "array_list<T>: T must be default constructible");
    // 插入/删除要搬动元素
    static_assert(std::is_move_assignable<T>::value,
                  "array_list<T>: T must be move assignable");
    static_assert(std::is_copy_assignable<T>::value || std::is_nothrow_move_assignable<T>::value,
                  "array_list<T>: non-replicable T must be able to be assigned values without any exceptions through movement");
    static_assert(!std::is_reference<T>::value,
                  "array_list<T>: T must not be reference");

    array_list() noexcept = default;

    explicit array_list(size_type capacity)
        : capacity_(capacity), data_(capacity ? new T[capacity] : nullptr) {}

    array_list(const array_list& other)
        : capacity_(other.capacity_),
          size_(other.size_),
          data_(other.capacity_ ? new T[other.capacity_] : nullptr) {
        for (size_type i = 0; i < size_; ++i) {
            data_[i] = other.data_[i];
        }
    }

    array_list& operator=(const array_list& other) {
        if (this != &other) {
            array_list copy(other);
            swap(copy);
        }
        return *this;
    }

    array_list(array_list&& other) noexcept { swap(other); }

    array_list& operator=(array_list&& other) noexcept {
        if (this != &other) {
            // std::move 将左值转为右值引用
            // 从而避免拷贝
            array_list moved(std::move(other));
            swap(moved);
        }
        return *this;
    }

    ~array_list() { delete[] data_; }

    void swap(array_list& other) noexcept {
        using std::swap;
        swap(capacity_, other.capacity_);
        swap(size_, other.size_);
        swap(data_, other.data_);
    }

    // 返回值不能被丢弃
    [[nodiscard]] bool empty() const noexcept { return size_ == 0; }
    [[nodiscard]] size_type size() const noexcept { return size_; }
    [[nodiscard]] size_type capacity() const noexcept { return capacity_; }

    // 清空会保留已分配容量
    void clear() noexcept { size_ = 0; }

    // 读取相关实现
    // 按下标 O(1) 读取,越界抛出 std::out_of_range
    [[nodiscard]]
    const T& at(size_type index) const {
        check_index(index, "array_list::at");
        return data_[index];
    }

    T& at(size_type index) {
        check_index(index, "array_list::at");
        return data_[index];
    }

    void set(size_type index, const T& value) {
        check_index(index, "array_list::set");
        data_[index] = value;
    }

    // 查找
    // 按内容 O(n) 查找,未找到返回 std::nullopt
    [[nodiscard]]
    std::optional<size_type> find(const T& value) const {
        for (size_type i = 0; i < size_; ++i) {
            if (data_[i] == value) {
                return i;
            }
        }
        return std::nullopt;
    }

    // 插入相关实现
    // 在位置 pos 插入元素,pos 可以等于 size()
    // 位置非法时抛出 std::out_of_range
    // 容量不足时自动翻倍
    // pos 之后的元素都要右移一位,故 O(n)
    void insert(size_type pos, const T& value) {
        make_gap(pos);
        data_[pos] = value;
        ++size_;
    }

    void insert(size_type pos, T&& value) {
        make_gap(pos);
        data_[pos] = std::move(value);
        ++size_;
    }

    void append(const T& value) { insert(size_, value); }
    void append(T&& value) { insert(size_, std::move(value)); }

    // 删除
    // 删除位置 pos 上的元素并返回
    // 位置非法时抛出 std::out_of_range
    T remove(size_type pos) {
        check_index(pos, "array_list::remove");
        T removed = std::move(data_[pos]);
        for (size_type i = pos; i + 1 < size_; ++i) {
            data_[i] = std::move(data_[i + 1]);
        }
        --size_;
        return removed;
    }

    // 用裸指针当迭代器
    [[nodiscard]] T* begin() noexcept { return data_; }
    [[nodiscard]] T* end() noexcept { return data_ + size_; }
    [[nodiscard]] const T* begin() const noexcept { return data_; }
    [[nodiscard]] const T* end() const noexcept { return data_ + size_; }

private:
    static constexpr size_type initial_capacity = 4;

    // 私有数据
    size_type capacity_{0};
    size_type size_{0};
    T* data_{nullptr};

    void check_index(size_type index, const char* who) const {
        if (index >= size_) {
            throw std::out_of_range(who);
        }
    }

    // 在 pos 处腾出一个空位
    // 先保证容量,再把 [pos, size_) 整体右移一位
    void make_gap(size_type pos) {
        if (pos > size_) {
            throw std::out_of_range("array_list::insert: illegal place of insertion");
        }
        ensure_capacity();
        for (size_type i = size_; i > pos; --i) {
            data_[i] = std::move(data_[i - 1]);
        }
    }

    // 扩大容量
    void ensure_capacity() {
        if (size_ < capacity_) {
            return;
        }
        constexpr size_type k_max = std::numeric_limits<size_type>::max();
        if (capacity_ > k_max / 2) {
            throw std::overflow_error("array_list: doubling capacity will overflow");
        }
        const size_type next = capacity_ == 0 ? initial_capacity : capacity_ * 2;
        T* fresh = new T[next];
        try {
            for (size_type i = 0; i < size_; ++i) {
                if constexpr (std::is_nothrow_move_assignable<T>::value) {
                    fresh[i] = std::move(data_[i]);
                } else {
                    fresh[i] = data_[i];
                }
            }
        } catch (...) {
            delete[] fresh;
            throw;
        }
        delete[] data_;
        data_ = fresh;
        capacity_ = next;
    }
};

template <typename T>
void swap(array_list<T>& a, array_list<T>& b) noexcept {
    a.swap(b);
}

}
实际上 std::vector 的实现也是在扩容时移动到更大的区域,只不过一些实现可能不是两倍。扩容时向操作系统申请连续虚拟地址(并不需要物理上连续)。如果忽略掉一些底层机制,申请需要 $O(\log n)$ 而随机访问是 $O(1)$.
链表
所谓有头节点的单链表(singly linked list),就是:
--head--> [10 | -]---> [8 | -]---> [50 | /]每个节点类型是 struct Node { T value; Node* next; };;双链表、循环链表等同理。
栈与队列
栈
栈(stack)是限定仅在一端进行插入和删除运算的线性表,该端称为栈顶,另一端称为栈底。栈的元素按后进先出(LIFO, last in first out)的次序访问:最后压入的元素最先弹出。
push(x)、pop()、top()、isempty()、size()、clear() 操作都是 $O(1)$ 的。超过容量时 push 称为 overflow,对空栈 pop 称为 underflow.
顺序栈和链式栈的实现方式略去。
递归调用时,系统运行栈中每个活动记录(栈帧)主要保存返回地址、实在参数、本层的局部变量(及需要保护的寄存器现场)。-O2 优化有时会把递归转为循环。
设有 $n$ 个元素按 $1, \dots, n$ 的顺序依次入栈(中途可任意出栈),则可能得到多少种不同的出栈序列?
按照 $1$ 的输出顺序,结果 $C_n$ 满足:
$$C_n = \sum_{i=0}^{n-1} C_i C_{n-1-i}$$
实际上这就是 Catalan 数,$C_n = C_{2n}^n / (n+1)$,可以使用反射法:$C_n$ 对应于每次升/降 $1$,共 $n$ 个升/降,恒在 $x$ 轴上的折线。不合法的折线可以在第一次达到 $-1$ 以后的部分关于 $y = -1$ 对称,得到与 $n - 1$ 升 $n + 1$ 降折线的一一对应。于是不合法的有 $C_{2n}^{n-1}$ 种。
调度场算法
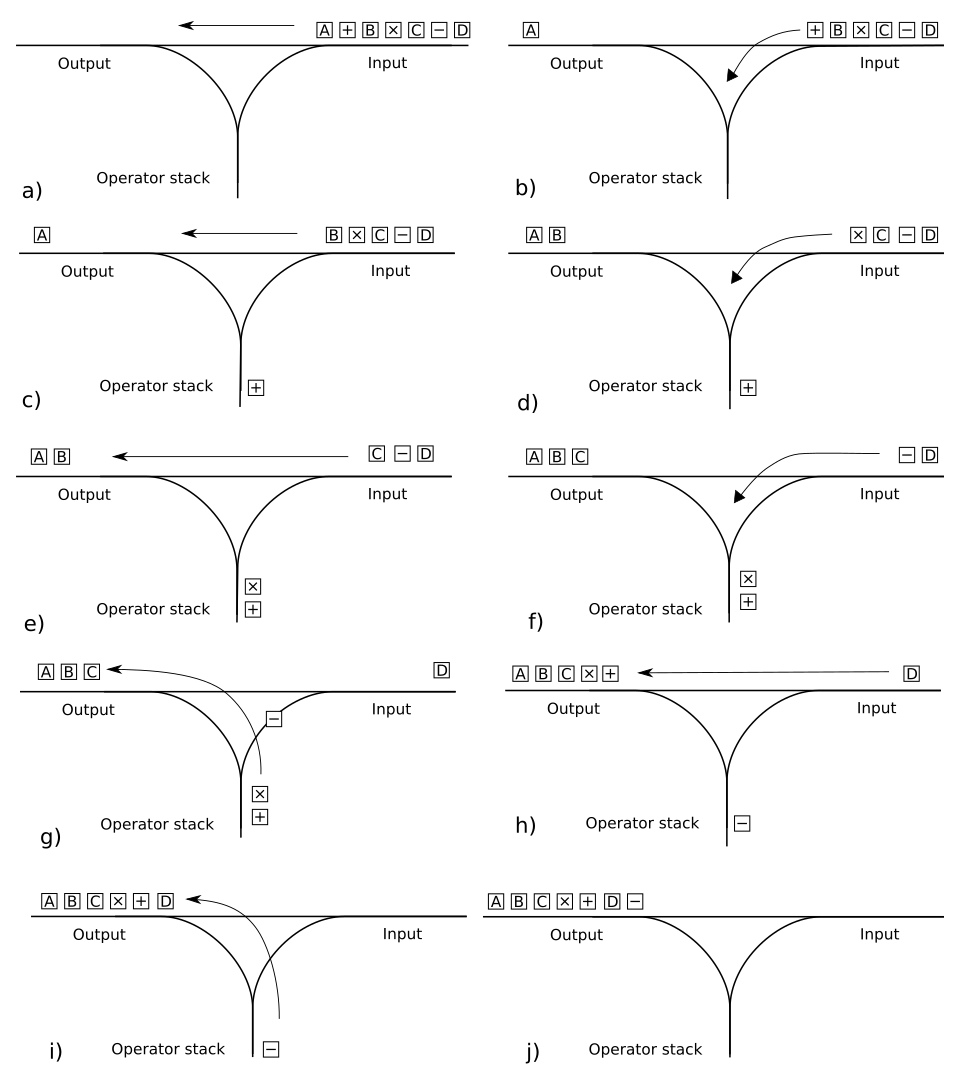
后缀表达式的计算只需要用栈就行。现在考虑将中缀表达式转化为后缀表达式的栈方法。
将表达式从左到右依次扫描,维护一个操作栈,按下表规则作处理:
| 对象 | 操作 |
|---|---|
| 操作数 | 直接输出到后缀序列 |
左括号 ( | 入操作栈 |
右括号 ) | 反复弹出并输出,直到遇到 (;( 弹出但不输出;若未遇到说明括号不匹配 |
| 运算符 | 当栈非空且栈顶不是 ( 且栈顶优先级不低于当前时反复弹出并输出;然后把当前运算符入栈 |
| 扫描结束 | 剩余的依次弹出输出;若弹出 (,说明括号不匹配 |
参考以下来自 Wikipedia 的图片:
队列
队列(queue)是限定元素只能从表的一端插入,另一端删除的线性表。只允许删除的一端称为队头(front),删除操作称为出队(dequeue);另一端为队尾(rear),插入操作称为入队 (enqueue)。队列的元素先进先出(FIFO, first in first out)表。
关于顺序队列、链式队列的实现;用两个栈来实现队列略去。
有一个长为 $n$ 的序列 $a$,以及一个大小为 $k$ 的窗口。现在这个窗口从左边开始向右滑动,每次滑动一个单位,求出每次滑动后窗口中的最小值。
核心想法是,老而更劣的元素不可能成为最值。用一个双端队列(deque)维护一个单调队列($i < j$ 时 $s_i < s_j$),新加入元素时,在右侧移除大于等于它的元素然后加入它,再从左侧移除离开窗口的元素。
deque<tuple<int, int>> s;
for (int i = 0; i < k; i++) {
    int current = a[i];
    while (!s.empty() && get<1>(s.back()) > current) s.pop_back();
    s.push_back(make_tuple(i, current));
}
cout << get<1>(s.front());
for (int i = k; i < n; i++) {
    int current = a[i];
    if (!s.empty() && get<0>(s.front()) <= i - k) s.pop_front();
    while (!s.empty() && get<1>(s.back()) > current) s.pop_back();
    s.push_back(make_tuple(i, current));
    cout << " " << get<1>(s.front());
}
字符串
C++ 中由于历史遗留问题,字符串字面量 "abc" 的类型是 char*,实际上是一段连续字符并以 \0 结尾。因此比较字符串时需要先转成 std::string,此时是字典序("a" < "ab")。
关于字符串的重要算法是模式匹配。这里只考虑匹配子串的问题。对于串 "abababd" 和子串 "ababd",匹配最开头不同后朴素的算法是重新从第二位开始匹配,但实际上我们已经知道前四位是什么了。我们去看 "abab" 的前缀和后缀里最长的相同一段:
a ab aba
b ab bab
是 "ab",因此我们只需要重新从第三位开始匹配。同理,可以定义字符串的特征数组 next,标记在该处匹配失败时应退到的位置(见后文 KMP 算法):
| 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| a | b | a | b | d |
| -1 | 0 | -1 | 0 | 2 |
next 数组计算方式如下:
def build_next(pattern: str) -> list[int]:
    if not pattern:
        return []
    next_values = [-1] * len(pattern)
    i = 0
    k = -1
    while i < len(pattern):
        while k >= 0 and pattern[i] != pattern[k]:
            k = next_values[k]
        i += 1
        k += 1
        if i == len(pattern):
            break
        next_values[i] = next_values[k] if pattern[i] == pattern[k] else k
    return next_values
然后 KMP 算法即:
def kmp_search(text: str, pattern: str) -> int | None:
    next_values = build_next(pattern)
    i = 0
    j = 0
    while i < len(pattern) and j < len(text):
        if i == -1 or text[j] == pattern[i]:
            i += 1
            j += 1
        else:
            i = next_values[i]
    return j - len(pattern) if i == len(pattern) else None
有些实现中用的是另一个数组 lps,lps[i] 表示 pattern[0..i] 的最长相等真前后缀长度。计算方法为:
def build_lps(s: str) -> list[int]:
    lps = [0] * len(s)
    for i in range(1, len(s)):
        k = lps[i - 1]
        while k > 0 and s[i] != s[k]:
            k = lps[k - 1]
        if s[i] == s[k]:
            k += 1
        lps[i] = k
    return lps
这与 next 的关系是 next 约定 next[0] = -1,next[i + 1] = lps[i],然后优化掉无用的回退(如果预期回退到的字母相同则继续回退)。
二叉树
定义与实现
二叉树指的是:每个节点有严格区分的左子树、右子树(可以为空)。对非空的二叉树,定义其根的层数为零。最大的层数称为深度,高度定义为深度加 $1$.
满二叉树(full binary tree)定义为没有度为 $1$ 的节点;完全二叉树(complete binary tree)定义为除最下面两层外节点度均为 $2$,且最下层的结点从左到右连续排列、没有空洞的树;完美二叉树定义为深度 $k$ 时恰有 $2^{k+1}-1$ 个节点的树。
二叉树典型的深度优先遍历方式是:先序(先根,然后归纳地便利左子树,然后右子树)、中序(左、根、右)、后序(左、右、根),递归(或模拟递归)即可。广度优先遍历方式是按层数遍历,使用队列:
template <typename T>
void traversal(binary_tree<T> tree, void (*visit)(T)) {
    queue<int> list;
    list.push(tree.root);
    while (!queue.empty()) {
        T node = queue.pop();
        visit(node);
        if (tree.has_left()) queue.push(tree.get_left());
        if (tree.has_right()) queue.push(tree.get_right());
    }
}
二叉树常见的存储方式是链式存储与顺序存储($i$ 的左、右子节点下标 $2i+1, 2i+2$)。
二叉搜索树
二叉搜索树(binary search tree,BST)是为了避免动态增减变化需要移动大量元素的结构。其满足的是:一个节点左子树上所有节点都小于它的值,右子树上所有节点都大于它的值。在树比较平衡时,插入效率较高;而删除比较复杂。
删除有两个子树的节点时,将左子树的最右节点代替该节点,如果这里最右节点有左子树则需要先移走。如果只有一侧子树,上移即可。
堆与优先队列
堆处理的是频繁在一组对象中查找最大值或最小值,避免反复排序的问题。最小堆(min-heap)是一个序列 $\{K _i\} _0^{n-1}$,具备的特性是 $K _i \leq K _{2i+1}, K _{2i+2}$. 在插入时,先将元素添加在队尾,然后不断与上级节点比较、交换,直到满足性质。
在删除时,我们直接将末尾元素填到空中,然后如果这个元素小于现在上级节点,则不断上浮,否则不断下沉,直到符合要求。
在建堆时,从 $\lfloor n/2 \rfloor - 1$ 往前依次向下调整,理解为每次合并两个堆,此时间复杂度 $\Theta(n)$.
优先队列适合查找和删除最小元素,可以应用于操作系统的进程调度管理。堆就是很好的优先队列实现方式。
Huffman 树
Huffman 树是这样建立的:每次取出两个最小权,将它们合成一棵树,新的权是它们之和。这一过程使用堆就可以 $O(n\log n)$ 完成。
Huffman 树的特性是最小化带权路径长度(Weighted Path Length of Tree, WPL),即所有叶子的权重乘以深度的求和。
其用途是给字符编码。如果要传输的信息中字符 $c_i$ 有 $k_i$ 个,用这些 $k_i$ 建树,从根节点开始往左标 $0$ 往右标 $1$,此序列即单个字符的编码。这天然使得任何字符的编码都不是另一个字符编码的前缀,从而对一串编码的拼接,可以解码。
树
基本性质
我们可以将森林转换成二叉树:先将同级节点连起来,然后砍掉上级节点到除第一个子节点以外节点的连线,再旋转即可。
树有深度优先的先根次序、后根次序及广度优先。
链式存储
“子节点表”表示方法是:维护一个关于各节点信息的数组,内容包括节点信息、上级节点索引,及链表存储的子节点索引。
这种表示方法的一个改进是:每个节点处不再存储所有子节点,而是存储其最左的子节点与其右侧的同级节点的索引,称为 left child / right sibling 表示法。
两种表示法也有对应的动态版本,即把数组维护改为用指针。
并查集
并查集(disjoint set)是一种管理元素所属集合的数据结构,实现为一个森林。其支持的操作是:合并两个元素所属集合(合并对应的树);查询某个元素所属集合(查询对应的树的根节点)。
我们只需要维护每个节点的上级节点索引。
int find(int x) {
    if (parent[x] != x) {
        // 路径压缩
        parent[x] = find(parent[x]);
    }
    return parent[x];
}

void unite(int x, int y) {
    parent[find(x)] = find(y);
}
可以稍微优化一下,维护每棵树的大小,合并时将节点较少的树连到另一颗。Tarjan 证明了不使用启发式合并,最坏时间复杂度 $O(m \log n)$,姚期智证明了不使用启发式合并,平均时间复杂度 $O(m \alpha(m, n))$,其中 $\alpha$ 是 Ackermann 函数的反函数。
顺序存储
顺序存储表示法中,节点存储在一片连续的存储单元。
“带右链的先根次序表示”对标于先根次序序列,会在每个节点处存储其是否是叶节点,及对应的二叉树中右节点(若有)。
“带双标记的先根次序表示”只会在每个节点处存储其是否是叶节点、对应的二叉树中是否有右节点。
“带度数的后根次序表示”对标于后根次序序列,会在每个节点处存储其度数。
“带双标记的层次次序表示”对标于层次次序序列,会在每个节点处存储其是否有子节点、是否有右同级节点。
只在这里出现一次工程版,给读者一个大致印象。